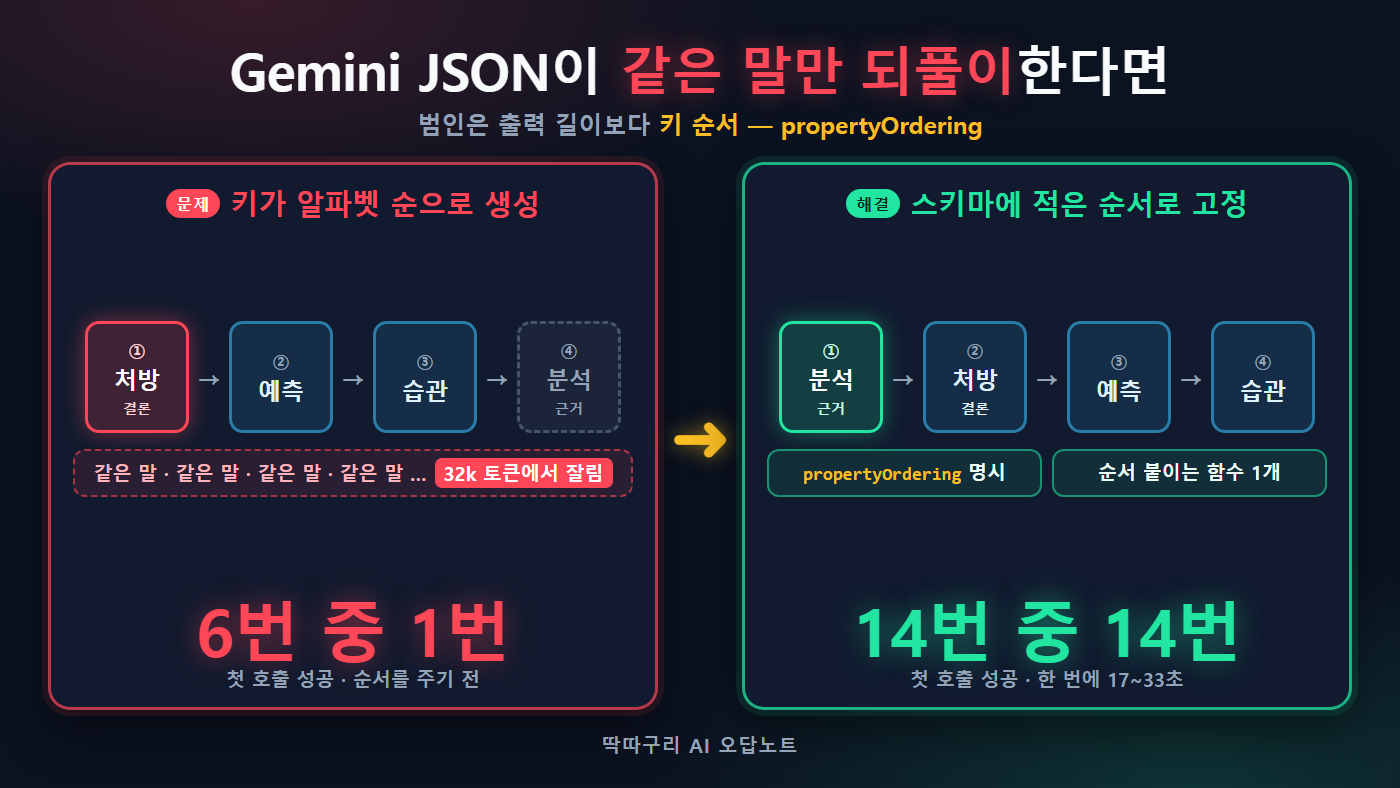
- 증상: Gemini에 JSON 스키마를 주고 분석·처방을 받는데, 첫 호출이 같은 문구를 되풀이하다 출력 상한(32k 토큰)에 닿아 잘린다. 성공은 6번 중 1번
- 원인: 스키마에
propertyOrdering이 없어 키가 알파벳 순으로 생성됐다. 「처방(결론)」 칸이 「분석」 칸보다 먼저 나와, 분석 없이 결론부터 쓰다 문자열을 닫지 못했다 - 해결에 걸린 것: 기각한 가설 7개와 탐색 비용 약 $3.4. 고친 건 스키마의 모든 object에 선언 순서를 붙이는 헬퍼 함수 하나(10줄)였고, 그 뒤 첫 호출 성공이 14번 중 14번이 됐다
순서는 증상 → 헛짚은 가설 7개 → 진짜 원인과 공식 문서 → 고친 코드 → 체크리스트입니다.
1. 혹시 이런 상황인가요?
Gemini API에 JSON 스키마를 주고 「이 형식으로만 답해」라고 시키는 기능을 쓰고 있습니다. 대부분은 잘 되는데, 어떤 요청은 응답이 끝없이 길어집니다.
열어 보면 같은 문장이나 숫자가 반복되다가 중간에서 잘려 있고, JSON으로 읽을 수도 없습니다.
이런 조건이라면 이 글이 맞습니다.
responseMimeType: 'application/json'과responseSchema로 구조화 출력을 받는다- 스키마 안에 「분석」과 「결론·요약·처방」처럼 먼저 써야 뒤가 나오는 칸이 함께 있다
- 실패한 응답의 종료 이유(finishReason)가
MAX_TOKENS다. 출력 상한까지 다 쓰고 멈췄다는 뜻이다 - 출력 상한을 올리거나 재시도를 붙여도 성공률이 거의 안 오른다
구조화 출력(structured output): 모델에게 JSON 스키마를 주고, 그 모양대로만 답하게 하는 기능입니다. 코드가 응답을 바로 읽을 수 있어서 앱에 AI를 붙일 때 거의 필수로 씁니다.
2. 저도 똑같이 당했습니다
저는 수학 과외를 하면서 학생 시험지를 분석해 주는 앱을 AI와 함께 만들고 있습니다. 선생님이 채점을 확정하면, AI가 그 결과로 「분석」과 「다음에 무엇을 공부할지(처방)」를 써 주는 기능이 있습니다.
그 AI 호출이 이 글의 무대입니다. 한 번 부르면 분석·처방·성장 예측·학습 습관 같은 칸 7개를 JSON 하나로 받아 옵니다.
9월 30일 저녁, 이 호출이 가상 학생 데이터로 돌린 점검에서 계속 실패했습니다.
원인 추적은 제 앱을 맡은 AI 작업 창이 했고, 저는 보고를 받고 비용과 머지를 결정하는 자리에 있었습니다. 아래는 그날 로그를 다시 읽고 쓴 사후 기록입니다.
① 증상 — 32k 토큰을 72초 동안 쓰고 잘렸다
증상 첫 호출이 출력 상한 32k 토큰까지 가서 MAX_TOKENS로 끝났습니다. 72초가 걸렸고, 그동안 재시도에 쓸 시간 예산까지 먹어 버렸습니다.
응답 끝부분은 응원 문구, 문항 번호, 「1 1 1」 같은 숫자가 되풀이되는 모양이었습니다.
원인 추정 AI의 첫 판단은 「답이 너무 길다」였습니다. 그래서 첫 번째 대응은 길이를 묶는 쪽이었습니다.
고침 AI가 출력 상한을 32k에서 16k로 낮추고, 자유 서술 칸마다 maxLength(최대 글자 수)를 1,000자로 걸었습니다.
확인 요청이 거절(400)되지는 않았지만, maxLength는 지켜지지 않았습니다. 여전히 한 칸이 폭주했습니다.
② 헛짚은 가설 7개 — 대부분 6번 중 1번 성공
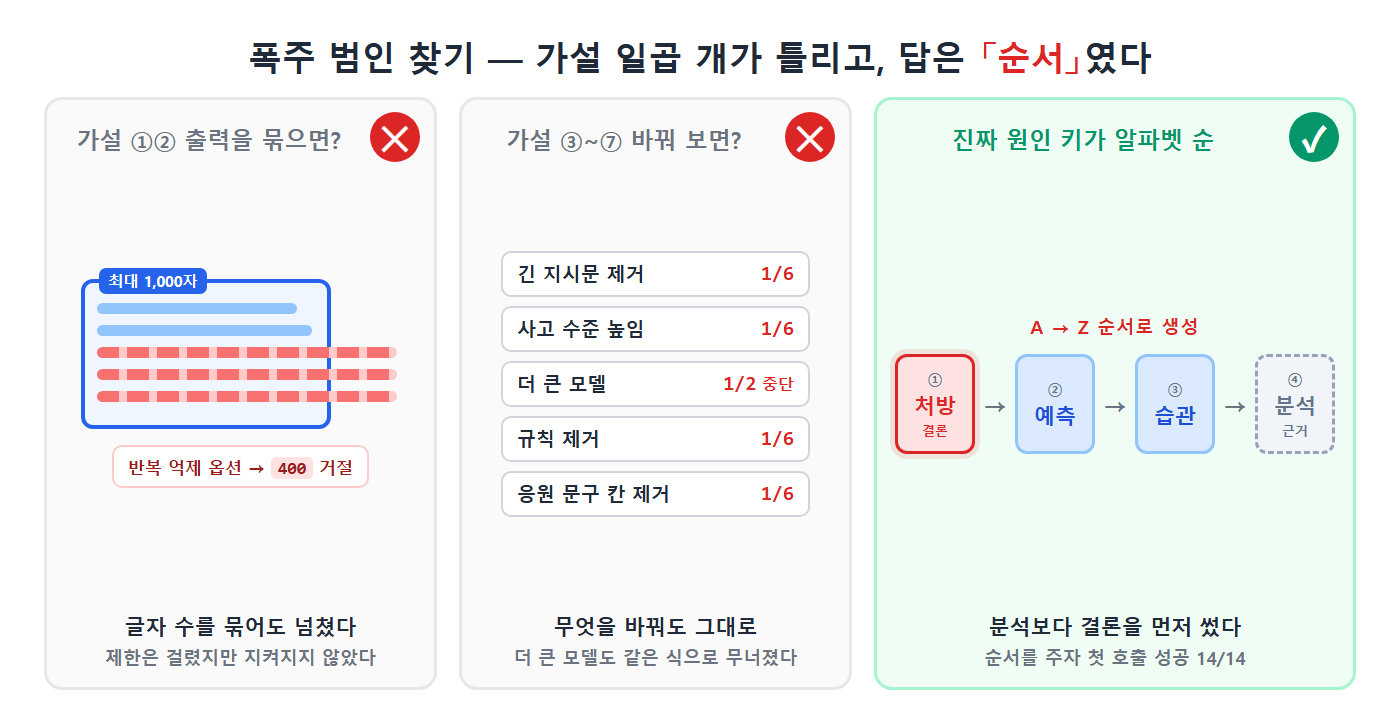
그다음부터 AI는 가설을 하나씩 바꿔 가며 같은 조건으로 재 봤습니다. 대부분은 실패한 가상 리포트 두 건에 각 3번씩, 모두 6번 호출하는 방식이었습니다.
결과는 이렇습니다(첫 호출 성공 수 / 호출 수).
| 가설 | 바꾼 것 | 결과 |
|---|---|---|
| 1 | 칸마다 maxLength | 1/4 — 거절은 없지만 강제되지 않음 |
| 2 | frequencyPenalty(반복 억제) | 0/4 — 모델이 400으로 거절, 적용 자체가 안 됨 |
| 3 | 앞에 붙는 긴 분석 지시문 제거 | 1/6, 오히려 나빠지고 RECITATION 종료까지 |
| 4 | 사고 수준 thinkingLevel: high | 1/6 |
| 5 | 모델을 gemini-2.5-pro로 교체 | 1/2에서 중단 — 역시 폭주, 2분씩 걸림 |
| 6 | 「오답을 전부 다뤄라」 규칙 제거 | 1/6 |
| 7 | 반복되던 응원 문구 칸 제거 | 1/6 |
가설 2에서 받은 거절 메시지는 이랬습니다.
Penalty is not enabled for this model
5번이 방향을 바꿨습니다. 더 큰 모델도 같은 식으로 무너지니, AI는 모델 문제가 아니라 입력 쪽 문제라고 판단했습니다.
그래서 실제로 보내는 프롬프트를 파일로 떠서 살펴봤고, 규칙을 빼고(6) 응원 문구 칸을 빼 봤지만(7) 여전히 1/6이었습니다. 이 탐색 호출과 폭주분에만 약 $3.4가 들었습니다.
3. 원인은 이거였습니다
① 키가 알파벳 순으로 생성됐다 — 결론이 분석보다 먼저
증상 스키마에는 칸을 「분석 → 처방 → 예측 …」 순서로 적어 뒀습니다. 사람이 풀이를 쓰듯, 먼저 분석하고 그걸 근거로 처방을 쓰라는 뜻이었습니다.
원인 그런데 propertyOrdering이 없으니 Gemini가 키를 알파벳 순으로 썼습니다. 맨 위 7개 칸만 보면 이렇게 바뀝니다.
| 순번 | 스키마에 적은 순서 | 실제 생성 순서(알파벳) |
|---|---|---|
| 1 | macroAnalysis (분석) | actionablePrescription (처방) |
| 2 | actionablePrescription (처방) | growthPredictions |
| 3 | growthPredictions | learningHabits |
| 4 | learningHabits | macroAnalysis (분석) |
| 5 | riskFactors | riskFactors |
| 6 | swotAnalysis | swotAnalysis |
| 7 | trendComment | trendComment |
처방이 1번, 분석이 4번이 됩니다. 알파벳 순이라면 분석 칸 안에서도 futureVision은 summary보다, weaknessFlow는 weaknesses보다 앞에 옵니다. 실제로 첫 폭주 지점도 futureVision 칸이었습니다.
기록된 결론은 이렇습니다. 모델이 근거를 쓰기 전에 결론 칸부터 채우다가 문자열을 닫지 못하고 같은 말을 되풀이했다는 것입니다.
고침 모든 object에 「스키마에 적은 순서대로 써라」를 명시했습니다(4절).
확인 임시 실험 코드로 10번 중 10번, 실험 코드를 다 걷어 낸 정식 코드로 4번 중 4번 성공했습니다. 합쳐서 14/14, 한 번에 1733초, 출력 3.03.9k 토큰이었습니다.
propertyOrdering: 구조화 출력 스키마에서 「이 칸들을 이 순서로 생성하라」를 정하는 필드입니다. 공식 문서는 이 필드가 구조화 출력 전용이고 Vertex AI 스키마 정의의 일부가 아니라고 설명합니다.
② 공식 문서는 뭐라고 하나 — SDK에 따라 다르다고 적혀 있다
글을 쓰면서 AI에게 공식 문서 원문을 떠 오게 했습니다(2026-10-01). Google Cloud의 Vertex AI 문서 Control generated output에 이런 문장이 있습니다.
When you define a schema, the model doesn’t strictly follow the order of properties that you define in the properties field.
If you use the Python SDK, the default property ordering follows the order that is defined in your schema. For all other cases, properties are generated alphabetically with the required properties grouped first followed by optional properties.
제 앱은 Python이 아니라 자바스크립트 SDK(@google/genai)였고, 기본 모델은 gemini-3.7-flash였습니다. 다만 Vertex AI가 아니라 API 키로 부르는 Gemini API라서, 이 문서가 그대로 적용된다고 단정할 수는 없습니다. 관찰이 「그 밖의 경우 = 알파벳 순」 서술과 일치했다는 것까지만 말할 수 있습니다.
게다가 같은 문서에 「구조화 출력은 스키마의 키 순서대로 출력한다」는 문장도 함께 있습니다.
그래서 문서만 믿고 기본 동작을 가정하지 말고, 순서가 중요하면 직접 박아 두는 편이 안전합니다. 제가 확인한 건 제 환경(JS SDK·responseSchema·위 모델)뿐입니다.
4. 이렇게 고쳤습니다
① 선언 순서 헬퍼 — 모든 object에 propertyOrdering을 붙인다
증상 칸이 많고 중첩된 스키마라서, propertyOrdering을 손으로 적으면 칸을 추가할 때마다 빠뜨릴 수 있습니다.
원인 순서 정보는 이미 스키마의 properties에 적은 순서 그대로 들어 있습니다. 그걸 꺼내 쓰기만 하면 됩니다.
고침 AI가 스키마를 끝까지 훑으면서 properties가 있는 object마다 그 키 목록을 propertyOrdering으로 붙이는 함수를 만들었습니다. 실제 코드입니다.
function withDeclaredPropertyOrder<T>(node: T): T {
  if (Array.isArray(node)) return node.map(withDeclaredPropertyOrder) as T;
  if (!node || typeof node !== 'object') return node;
  const out: Record<string, unknown> = {};
  for (const [key, value] of Object.entries(node)) {
    out[key] = key === 'enum' || key === 'required' ? value : withDeclaredPropertyOrder(value);
  }
  if (out.properties && typeof out.properties === 'object') out.propertyOrdering = Object.keys(out.properties);
  return out as T;
}

export const VERIFIED_DERIVED_GUIDANCE_SCHEMA = withDeclaredPropertyOrder(VERIFIED_DERIVED_GUIDANCE_SCHEMA_BASE);
enum과 required는 건드리지 않고 그대로 넘깁니다. 효과 없던 maxLength 헬퍼는 이걸로 교체했습니다.
헬퍼 없이 고친다면 이 모양을 손으로 적습니다. 제 스키마를 키 두 개로 줄이면 이렇고, 안쪽 object마다 따로 적어야 합니다.
const schema = {
  type: 'object',
  properties: {
    macroAnalysis: { type: 'object' /* 분석 칸들 … */ },
    actionablePrescription: { type: 'array' /* 처방 항목 … */ },
  },
  propertyOrdering: ['macroAnalysis', 'actionablePrescription'],
};
확인 별도 검수 AI가 완성된 스키마를 전부 순회해 봤습니다. 모든 object에서 propertyOrdering이 선언 순서와 같았고, enum·required는 원래대로 남아 있었습니다.
그날 밤 실제 재생성에서도 시험 4건의 분석·처방 생성(이 호출)이 모두 첫 호출에 성공했고, 재시도는 한 번도 없었습니다.
② 출력 상한 16k — 폭주가 나도 덜 태우게
증상 상한이 32k면 폭주 한 번에 72초가 사라지고, 재시도할 시간이 남지 않습니다.
원인 수리 전에 성공한 한 건의 정상 응답이 4,311 토큰이었으니 32k는 너무 넉넉했습니다. 반대로 8k는 재시도 응답이 8,177 토큰에서 잘린 적이 있어 모자랐습니다.
고침 AI가 첫 호출과 재시도 모두 16k로 맞췄습니다.
확인 순서를 고친 뒤 정상 출력은 3.03.9k 토큰(그날 밤 재생성에서도 2.93.9k)이라 16k 안에 여유 있게 들어옵니다.
③ 같은 뿌리로 의심되는 것 — 다른 스키마도 전부 순서가 없었다
증상 수리 직후 AI가 저장소를 훑어보니 propertyOrdering을 쓰는 스키마가 하나도 없었습니다. 그리고 그날 밤 재생성 도중, 이번에는 시험 분석 본체 호출이 30,569 토큰까지 가서 두 번 연속 중단됐습니다. 4.4분 뒤 500 에러로 끝났습니다.
원인 추정 본 분석·셀프 분석·주간·월간 스키마도 같은 알파벳 순일 가능성이 큽니다. 다만 아직 확인한 사실은 아니고 추정입니다.
이 폭주 직후 AI가 집계해 보니 탐색분을 포함한 그날 합계가 정해 둔 경보선을 넘어 있었고, 저는 상한 안에서 계속하라고 답했습니다.
고침 작업을 조율하는 AI 창이 전체 스키마에 같은 헬퍼를 적용하고 선언 순서가 「분석 → 결론」인지 점검하는 일을 다음 날 작업으로 등록했습니다.
확인 이 글을 쓰는 시점에는 아직 결과가 없습니다.
5. 같은 실수를 막는 체크리스트
- 구조화 출력이
MAX_TOKENS로 끝나면 출력 상한보다 키 순서를 먼저 의심한다 - 스키마에 「근거 → 결론」 순서가 필요한 칸이 있으면
propertyOrdering을 명시한다. 선언 순서가 지켜진다고 가정하지 않는다 - 칸 이름이 알파벳 순으로 어떻게 줄 서는지 한 번 적어 본다. 결론 칸(
action…,conclusion…,advice…)이 앞쪽에 오면 위험 신호다 - 손으로 적지 말고
properties에서 순서를 뽑아 붙이는 헬퍼 하나로 모든 스키마에 적용한다 - 헬퍼를 붙인 뒤 완성된 스키마를 순회하는 테스트로 모든 object에 순서가 붙었는지,
enum·required가 그대로인지 확인한다 -
maxLength같은 칸 제약은 요청이 거절되지 않아도 지켜진다는 보장이 없다. 실제 응답으로 확인한다 - 모델을 바꿔도 똑같이 무너지면 모델이 아니라 입력(프롬프트·스키마) 쪽을 본다
6. FAQ
Q. propertyOrdering을 넣으면 요청이 거절되지 않나요?
제 환경(자바스크립트 SDK @google/genai, responseSchema)에서는 거절 없이 동작했습니다.
Q. 출력 상한만 넉넉히 주면 해결되지 않나요?
32k에서도 폭주했습니다. 폭주는 길이 문제가 아니라 결론을 근거보다 먼저 쓰게 만든 순서 문제였습니다. 상한은 실패 비용을 줄일 뿐입니다.
7. 한 줄 교훈
AI에게 결론 칸을 먼저 주면, 근거 없이 결론을 쓰다가 무너진다. 폭주를 만나면 길이를 묶기 전에 칸이 어떤 순서로 생성되는지부터 봅니다.
학생에게 답부터 쓰고 풀이를 맞춰 넣게 하면 풀이가 엉키는 것과 같은 모양이었습니다. 스키마에도 풀이 순서가 있었던 셈입니다.
이 사건을 1분으로 줄인 쇼츠도 준비하고 있습니다. 영상이 올라가면 여기에 링크를 걸겠습니다.