- 무엇: 「내가 클로드코드를 잘 쓰고 있나」를 7개 축으로 채점시키는 발주서 전문입니다. 그대로 복붙하면 됩니다
- 난이도: 설치할 것 없음. 붙여넣고 기다리면 됩니다. 제 경우 트랜스크립트 856파일이 33초에 집계됐습니다
- 받는 법: 결과가 나온 뒤 「이 결과를 아티팩트로 만들어 줘」 한 줄이면 점수표 카드가 나옵니다. 제 결과를 그대로 아래 붙였습니다
1. 이런 문제 겪고 있다면
클로드코드를 몇 달 썼는데도 내가 이 도구를 제대로 쓰고 있는지 알 수가 없습니다. 잘 쓴다는 증거도, 못 쓴다는 증거도 없죠. 남들은 뭘 다르게 하는지도 모르겠고요.
저는 수학 과외에 쓸 도구를 만들려고 바이브코딩을 시작했는데, 어느 날 이게 걸렸습니다. 학생 답안은 채점 기준을 만들어 가며 채점하면서, 정작 제 실력은 기준도 없이 몇 달을 보냈다는 것.
그래서 채점을 시켰습니다. 기준까지 AI가 만들게 하고요. 그 결과가 아래 카드입니다.
2. 이 발주서가 하는 일
한 문단으로 끝내겠습니다. 이 발주서는 여러분 컴퓨터에 이미 쌓여 있는 대화 기록을 통계로 바꿉니다.
트랜스크립트: 클로드코드가 대화를 통째로 남겨 두는 기록 파일. ~/.claude/projects/ 아래에 프로젝트별로 쌓입니다.
몇 달 썼다면 이 폴더에 수백 개가 있습니다. 여기엔 여러분이 실제로 친 프롬프트가 전부 들어 있죠. 인상이 아니라 실측으로 채점할 재료가 이미 있다는 뜻입니다. 발주서는 그걸 세는 방법을 축별로 지정합니다.
3. 준비 — 세 가지만 확인
1) 요구 사항
- 클로드코드가 설치돼 있고, 몇 주 이상 실제로 써서 기록이 쌓여 있을 것. 어제 깔았다면 셀 게 없습니다
- 별도 설치는 없습니다. 프롬프트 하나면 됩니다
2) 기록이 쌓였는지 확인
돌리기 전에 셀 게 있는지부터 봅니다. 없으면 결과가 공허하게 통과하니까요.
ls ~/.claude/projects/
폴더가 프로젝트 수만큼 보이면 됩니다. 몇 개나 쌓였는지까지 보려면 이렇게 셉니다.
find ~/.claude/projects -name "*.jsonl" | wc -l
제 감사 결과엔 9개 프로젝트에 856개 파일로 찍혔습니다(실제 집계는 이 명령이 아니라 진단이 짠 스크립트가 했습니다). 이 숫자가 카드 맨 위에 그대로 나옵니다.
3) 새 세션에서 시작
진단은 새 창에서 돌리세요. 하던 작업이 남아 있는 창에서 돌리면 그 대화가 판단에 섞이고, 무엇보다 그 대화가 컨텍스트를 이미 차지하고 있어 집계 결과가 들어올 자리가 모자랍니다.
4. 실행 — 첫 1회
1) 발주서 전문
아래를 통째로 복사해서 붙여넣으면 됩니다.
# 발주: 전 프로젝트 Claude Code 사용 역량 감사 (7축)

## 목적
"클로드코드를 잘 쓰고 있는가"를 프로젝트 한 곳이 아니라 전 프로젝트 실측으로 판정한다.
아부·완곡어법 금지. 근거 없는 칭찬 금지. 각 판정은 파일 경로나 수치를 달고 나온다.

## 측정 대상
~/.claude/projects/ 아래 전 프로젝트 트랜스크립트(.jsonl),
각 프로젝트의 .claude/settings*.json / CLAUDE.md / skills / agents / hooks,
~/.claude/settings.json (전역).

## 7축과 측정 방법 (반드시 수치로)

1. 반복의 자산화 — 스킬·훅·커맨드·에이전트 수, CLAUDE.md 존재/길이.
   같은 절차를 자연어로 재설명한 흔적이 몇 번인지 세라.
2. 검증 루프 — 완료 판정이 테스트/명령 종료코드인가, 사람 눈인가.
   "확인해봐/맞아?/잘 됐나" 류 확인 요청 프롬프트 비율.
3. 위임의 폭 — subagent·background task·worktree 실사용 횟수 vs
   사람이 여러 세션을 손으로 병렬 운용한 정황(동시간대 세션 겹침).
4. 컨텍스트 위생 — 프로젝트별 세션 수 / 세션당 평균 MB / 컴팩션 횟수.
   🔴 컴팩션은 반드시 온전한 패턴으로 셀 것:
      grep -c '"subtype":"compact_boundary"' <transcript.jsonl>
      짧은 형태(compact_boundary)는 그 단어를 언급만 해도 세어져 값이 부풀려진다.
   기준: 컴팩션 1회 이상이면 그 지점이 원래 /clear 했어야 할 자리다.
5. 마찰 제거 — allowlist 규칙 중 (a)전역 allow가 비어 있어 프로젝트마다 되풀이 승인하는 항목
   (`Bash(git add:*)`와 `Bash(git add *)`는 공식 문서상 둘 다 유효하다 — 문법을 원인으로 삼지 말 것)
   (b)일회성 명령 전문이 박힌 쓰레기 항목. 각각 파일:항목으로 열거.
6. 상태 가시성 — statusline·output style 설정 여부, HANDOVER/WORKLOG 최신성,
   "지금 어디까지 했지" 류 프롬프트 빈도.

7. 프롬프트 퀄리티 (가장 비중 크게)
   전 프로젝트 user 메시지를 뽑아 아래를 실측하라.
   추출 예: jq -r 'select(.type=="user") | .message.content' *.jsonl
   ⚠️ user 타입에는 도구 실행 결과도 섞인다. tool_result 를 걸러야 사람 프롬프트만 남는다.

   7-1 정정률 — 직전 응답을 되돌리는 프롬프트 비율
       ("아니 그게 아니라", "다시", "취소", "원래대로", "왜 그걸 했어")
   7-2 성공기준 동봉률 — 검증 가능한 완료조건이 있는 비율
   7-3 증거 동봉률 — 파일경로·에러 원문·재현 절차를 준 비율 vs 무증거 신고 비율
   7-4 배치성 — 독립 요청을 한 메시지에 묶은 비율 vs 한 줄씩 쪼갠 비율
   7-5 되묻기 유발률 — Claude가 질문으로 되받은 비율
   7-6 길이 분포 — 20자 미만 단문 비율, 그 단문 뒤 정정률
   7-7 스킬 활용 — /스킬 호출 vs 같은 일을 자연어로 다시 설명한 비율

   각 지표에 대해 실제 프롬프트 3개를 원문 인용하고,
   같은 의도의 개선판을 옆에 나란히 써라(before/after).
   추상적 조언 금지 — 그대로 복붙할 수 있는 문장이어야 한다.

## 출력 형식
1. 7축 점수표(10점 만점) + 프로젝트별 편차 — 어느 프로젝트가 최악인지 명시
2. 전 프로젝트 공통 문제 / 특정 프로젝트 국한 문제를 분리
3. 프롬프트 before/after 최소 10쌍
4. 처방을 효과 순으로 5개, 각각 소요시간과 실행 명령까지
5. 마지막에 아부 없는 한 문단 총평

## 금지
- 측정 안 한 축을 추정으로 채우지 말 것. 못 쟀으면 "미측정"이라 쓸 것.
- 점수는 주관 채점이다. 실측치와 섞어 제시하지 말 것.
- 프롬프트 원문 인용 시 비밀·개인정보는 마스킹.
- 트랜스크립트는 크다. 전문 로딩 말고 jq/grep 집계로 처리할 것.
결과를 바꾸는 곳이 두 군데라 짚어 둡니다.
5축 (a) — 이 발주서 초판에는 「Bash(git add *) 같은 공백형은 무효일 수 있다」고 적혀 있었습니다. 공식 문서(permissions 문서)를 확인해 보니 틀렸습니다. 콜론형과 공백형은 같은 것을 매칭합니다. 연재 전체에서 그 줄을 고쳤고 위 전문에도 고친 판을 실었습니다. 없는 버그를 찾느라 시간 버리지 않으시게요.
4축 — 초판은 컨텍스트 위생을 「세션당 평균 MB / 20MB 초과 세션 수」로 재게 돼 있었고, 위 전문은 그걸 컴팩션 횟수 기준으로 바꾼 개정판입니다. 그래서 아래 제 카드는 개정 전 판으로 돌린 결과입니다 — 카드에 「20MB 초과 5세션」이 찍힌 건 그래서고, 위 전문을 그대로 돌리시면 그 자리에 컴팩션 횟수가 나옵니다. 왜 바꿨는지는 6절 첫 항목에 적었습니다.
2) 이어서 아티팩트 한 줄
집계가 끝나고 결과가 글로 쭉 나오면, 거기서 멈추지 말고 한 줄 더 보냅니다.
이 결과를 아티팩트로 만들어 줘.
이 한 줄이 긴 답변을 한 페이지짜리 카드로 다시 짭니다. 점수표·처방·체크리스트가 들어갈 자리를 지정하고 싶으면 그것까지 적으면 됩니다.
다만 정직하게 밝힐 게 있습니다. 아래 카드에는 점수표 말고도 「프롬프트 4원칙」과 「개발 환경」 절이 들어 있는데, 그건 이 한 줄만으로 나온 게 아닙니다. 저는 점수가 나온 뒤에 「그래서 앞으로 내가 어떻게 프롬프트를 작성하고 어떤 개발 환경에서 소프트웨어 엔지니어링을 어떻게 해나가야 하는지 알고 싶어」를 한 번 더 물었고, 그 답까지 합쳐 아티팩트로 만들어 달라고 한 결과입니다. 같은 카드를 받으시려면 그 질문도 넣으셔야 합니다.
아래가 제가 받은 결과입니다.

5. 실제로 이득 본 경험 — 제 결과 그대로
가리지 않고 그대로 싣습니다. 종합 5.7점이었습니다.
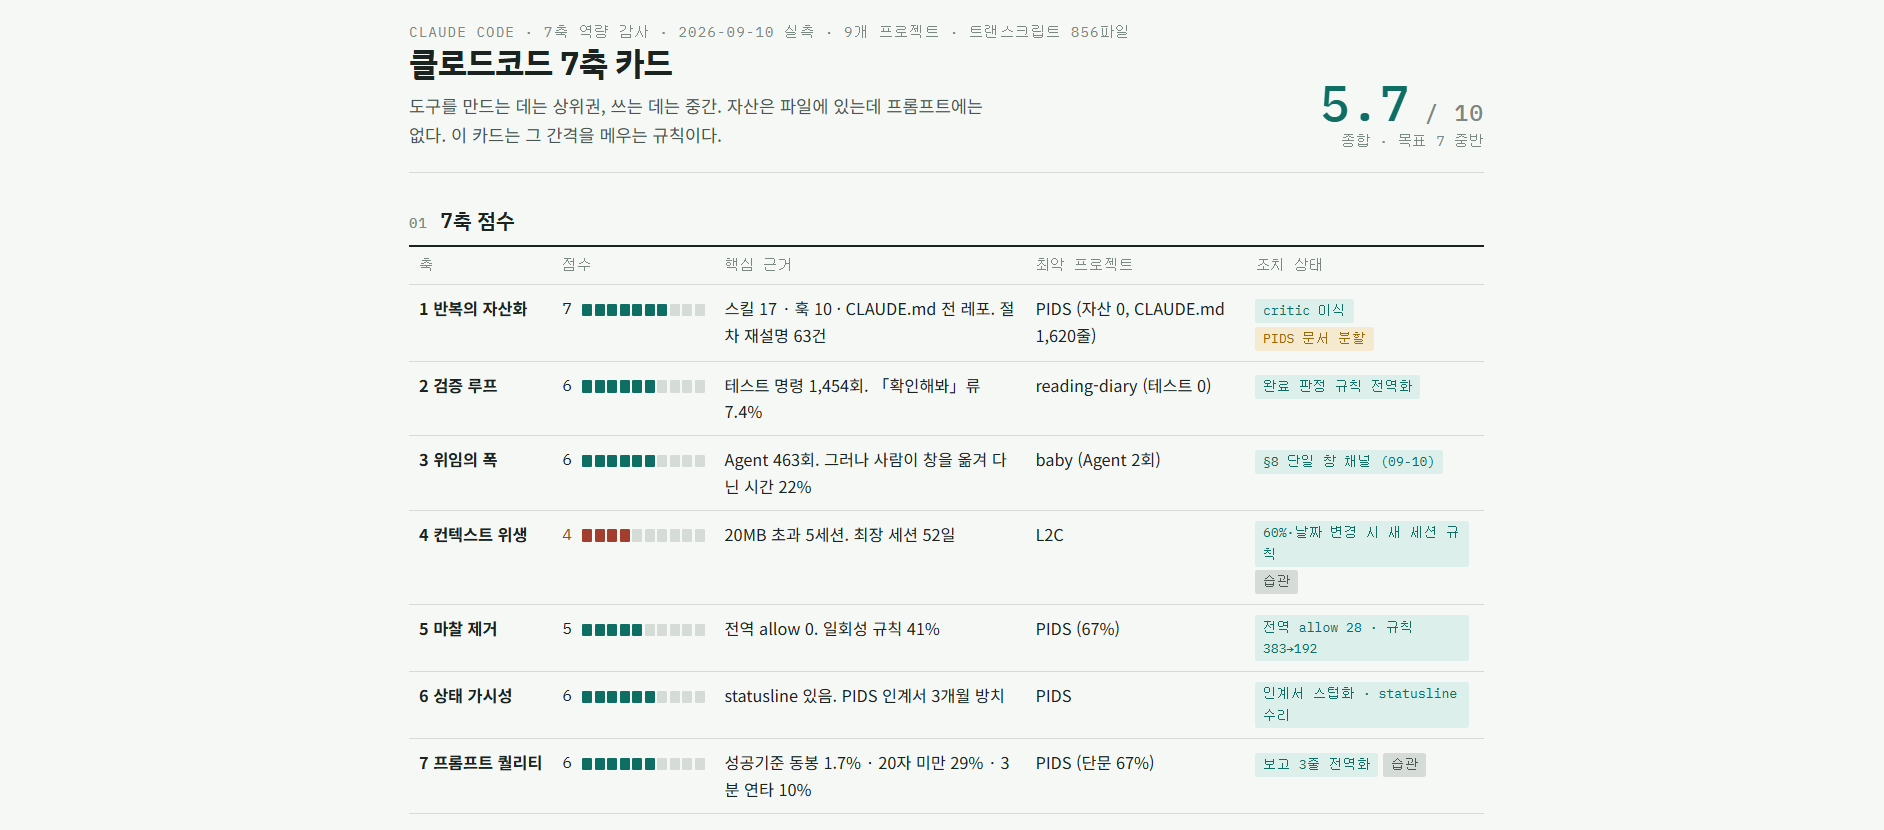
숫자보다 중요한 건 점수 옆에 근거가 붙어 나온다는 점입니다. 「컨텍스트 위생 4점」 옆에 「20MB 초과 5세션. 최장 세션 52일」이 있고, 그 옆에 어느 프로젝트가 최악인지까지 적혀 있죠. 발주서가 「각 판정은 파일 경로나 수치를 달고 나온다」를 요구했기 때문입니다. 이 한 줄이 없으면 그냥 별점이 나옵니다. 참고로 맨 오른쪽 「조치 상태」 열은 제가 그날 이미 손댄 것들이라, 여러분 카드엔 안 나옵니다.
총평은 이랬습니다. 「도구를 만드는 데는 상위권, 쓰는 데는 중간. 자산은 파일에 있는데 프롬프트에는 없다.」 스킬과 훅은 열심히 만들어 놓고 정작 프롬프트는 대충 던지고 있었다는 뜻입니다. 아프지만 맞는 말이었어요.
그리고 점수 뒤에 프롬프트를 고치는 원칙 넷이 붙습니다. 저는 이게 제일 값졌습니다.

추상적인 조언이 아니라 제가 실제로 친 문장과 그 개선판이 나란히 있습니다. 「머지해」가 「PR #6 머지. 조건: CI 초록 + 스레드 전부 resolved. 머지 후 main ff-only 동기화·브랜치 삭제. 보고는 SHA 한 줄.」로 바뀌는 식이죠. 이것도 발주서에 「그대로 복붙할 수 있는 문장이어야 한다」고 못 박아 둔 결과입니다.
마지막은 다섯 줄짜리 체크리스트로 닫힙니다.

카드 글씨가 작아 그대로 옮겨 적습니다. Enter 누르기 전 확인 다섯 줄입니다.
- 마지막 줄에 완료 조건이 있는가
- 문제 신고라면 경로·원문·재현·마지막 정상 시점이 붙어 있는가
- 1분 뒤 보낼 말이 남아 있지 않은가 (있으면 지금 붙인다)
- 결정이라면 범위가 문장 안에 있는가
- 상태줄이 60%를 넘었거나 날짜가 바뀌지 않았는가 (그렇다면 인계서 먼저)
6. 겪은 함정
첫째, 무엇으로 재느냐가 결론을 바꿉니다. 앞선 회차에서는 컨텍스트 위생을 파일 크기(MB)로 쟀습니다. 저는 그 순위를 그대로 믿고 「그럼 터미널에서도 주기적으로 /clear를 해줘야 하느냐」고 물었죠. 그런데 답 대신 정정이 돌아왔습니다. 「트랜스크립트 MB ≠ 컨텍스트 사용량」이라면서요. 컴팩션 횟수와 세션 수명으로 다시 잰 결과, 제 질문의 전제부터 틀려 있었습니다 — 제가 걱정한 그 터미널 프로젝트 둘(세션 딱 2개로 프로젝트 전체를 간 곳들)은 오히려 컴팩션이 0회였거든요. 파일이 큰 건 스크린샷과 도구 출력이 쌓인 것이지 모델이 짊어진 무게가 아니었습니다.
이번 7축 감사도 같은 기준으로 갈렸습니다. 세션을 89개나 굴리고도 컴팩션이 0회인 프로젝트가 있었고 — 예약 작업이 세션을 자동으로 끊어 준 덕이었죠 — 진짜 문제는 세션 하나가 52일을 산 쪽이었습니다. 그래서 위 전문의 4축 기준이 MB가 아니라 컴팩션 횟수입니다.
둘째, 그 컴팩션도 온전한 패턴으로 세야 합니다. 짧은 형태로 찾으면 그 단어를 언급만 한 줄까지 세어져 값이 부풀려집니다. 발주서의 첫 🔴가 그 자리입니다.
셋째, user 타입에는 사람 프롬프트만 있는 게 아닙니다. 도구 실행 결과도 같은 타입으로 들어옵니다. 이걸 안 거르면 프롬프트 개수가 부풀어 7축 비율이 전부 어긋나죠. 발주서의 tool_result 경고가 그 자리입니다.
넷째, 트랜스크립트를 통째로 읽히면 안 됩니다. 제 경우 전체가 800MB가 넘었습니다. 한 줄씩 읽어 세는 방식으로 지정했더니 33초에 끝났습니다.
7. FAQ
Q. 결과가 낮게 나오면 기분 나쁘지 않나요?
나쁩니다. 저도 5.7점이었고요. 다만 「아부·완곡어법 금지」를 넣은 게 이 진단의 값입니다. 좋게 말해 주면 고칠 자리를 못 찾습니다.
Q. 얼마나 걸리나요?
제 경우 집계 자체는 33초였습니다. 다만 그건 세는 스크립트가 완성된 뒤의 시간이고, 스크립트를 짜고 문법 오류로 몇 번 다시 돌리는 것까지 포함하면 40분쯤 걸렸습니다. 기록이 많을수록 오래 걸립니다.
Q. 개인정보가 섞이지 않나요?
발주서에 「프롬프트 원문 인용 시 비밀·개인정보는 마스킹」을 넣어 뒀습니다. 그래도 결과를 남에게 보여 줄 거라면 한 번은 직접 훑어보세요. 저도 이 글에 싣기 전에 확인했습니다.
Q. 아티팩트가 뭔가요?
클로드가 답변을 별도의 한 페이지로 만들어 주는 기능입니다. 긴 보고서를 표와 카드가 있는 페이지로 다시 짜 주는 것이라, 나중에 다시 열어 보기 좋습니다.
8. 그래서 뭘 하면 되나
| 시점 | 할 것 |
|---|---|
| 오늘 | 새 창을 열고 위 발주서를 통째로 붙여넣는다 |
| 오늘 | 점수가 나오면 「앞으로 어떻게 프롬프트를 쓰고 어떤 환경에서 일하면 되는지도 알려줘」를 한 번 더 묻는다. 카드의 원칙·환경 절이 여기서 나온다 |
| 오늘 | 그다음 「이 결과를 아티팩트로 만들어 줘」 한 줄을 더 보낸다 |
| 이번 주 | 가장 낮은 축 하나만 고른다. 처방에 붙어 나온 실행 명령을 그대로 돌린다 |
| 한 달 뒤 | 같은 발주서를 다시 돌려 점수를 비교한다 |
마지막 줄이 핵심입니다. 한 번 재고 끝나면 그냥 기분 상한 하루가 됩니다. 같은 자로 다시 재야 나아졌는지 알 수 있어요. 저는 학생들 성적도 그렇게 봅니다 — 한 번의 점수가 아니라 같은 시험을 두 번 본 차이로요.